Echtzeit-Datenverarbeitung für Unternehmen: Vorteile, Anwendungsfälle und Herausforderungen
Wie funktioniert Echtzeit-Datenverarbeitung, wo lohnt sie sich und was ist zu beachten? Vorteile, Architektur, Use Cases und Herausforderungen erklärt.
Echtzeit-Datenverarbeitung bedeutet, Daten innerhalb von Millisekunden oder Sekunden nach ihrer Entstehung zu erfassen, auszuwerten und darauf zu reagieren, statt sie zu sammeln und später in einem geplanten Batch-Lauf zu verarbeiten. Eine Zahlung wird auf Betrug geprüft, bevor sie verbucht wird. Eine Lieferroute ändert sich, während der Fahrer noch unterwegs ist. Eine Maschine in der Produktionshalle wird gemeldet, bevor sie ausfällt.
Wenn Ihr Unternehmen noch mit Berichten arbeitet, die zeigen, was gestern passiert ist, treffen Sie heutige Entscheidungen mit veralteten Informationen. Genau diese Lücke schließt die Echtzeit-Datenverarbeitung. Dieser Leitfaden erklärt, was dahintersteckt, wie sie technisch funktioniert, wo sie echten Nutzen bringt und welche Probleme Teams erfahrungsgemäß unterschätzen. Er richtet sich an Entscheider und technische Verantwortliche, die abwägen, ob und wie sie investieren sollten.
Was ist Echtzeit-Datenverarbeitung?
Echtzeit-Datenverarbeitung heißt, Daten kontinuierlich beim Eintreffen zu verarbeiten und Ergebnisse so schnell zu liefern, dass Menschen oder Systeme sofort darauf reagieren können. Das entscheidende Merkmal ist die geringe Latenz, also die Zeit zwischen einem Ereignis und der Reaktion Ihres Systems darauf.
"Echtzeit" ist dabei keine feste Geschwindigkeit. Ein Handelssystem an der Börse braucht unter Umständen Antworten in Mikrosekunden. Ein Dashboard im Einzelhandel kommt problemlos mit einer Aktualisierung alle zwei Sekunden aus. Entscheidend ist, dass die Verzögerung kurz genug bleibt, damit das Ergebnis bei seinem Eintreffen noch nützlich ist.
Echtzeit vs. Near-Realtime vs. Batch-Verarbeitung
Diese drei Begriffe werden ständig vermischt, deshalb lohnt sich eine klare Abgrenzung.
| Ansatz | Typische Latenz | Umgang mit den Daten | Typisches Beispiel |
| Batch-Verarbeitung | Minuten bis Stunden oder länger | Daten werden gesammelt und in geplanten Jobs verarbeitet | Nächtliche Verkaufsberichte, Gehaltsabrechnung |
| Near-Realtime | Sekunden bis wenige Minuten | Verarbeitung in kleinen, häufigen Micro-Batches | Bestands-Dashboards, Marketing-Analysen |
| Echtzeit | Millisekunden bis Sekunden | Jedes Ereignis wird beim Eintreffen verarbeitet | Betrugserkennung, Live-Fahrzeugortung, Sensoralarme |
Die meisten Unternehmen brauchen nicht alles in Echtzeit, und das ist völlig in Ordnung. Für Aufgaben wie den Monatsabschluss oder umfangreiche historische Analysen bleibt Batch die richtige Wahl. Entscheidend ist zu erkennen, welche Prozesse durch Verzögerung tatsächlich an Wert verlieren.
Wie funktioniert Echtzeit-Datenverarbeitung?
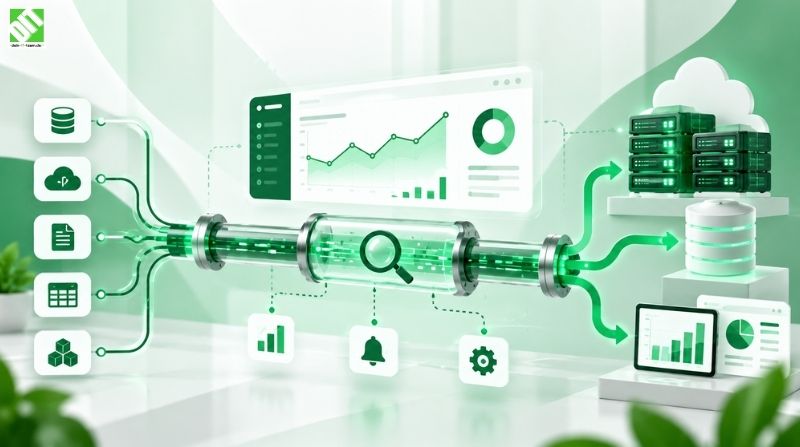
Eine Echtzeit-Pipeline führt Daten grob durch fünf Stufen. Die eingesetzten Werkzeuge unterscheiden sich von Projekt zu Projekt, das Grundmuster bleibt aber erstaunlich konstant.
Erfassung (Ingestion). Daten gelangen aus ihren Quellen ins System: Anwendungsereignisse, Klicks, IoT-Sensoren, Transaktionen, Logs, Drittanbieter-Dienste oder Datenbanken, die Änderungsereignisse senden.
Transport. Die Daten werden an eine Streaming-Schicht oder einen Message Broker übergeben, der sie puffert, in Reihenfolge hält und zuverlässig an alle Empfänger verteilt.
Verarbeitung. Eine Stream-Processing-Engine filtert, reichert an, aggregiert oder analysiert jedes Ereignis, oft im Abgleich mit der jüngeren Historie oder einem Machine-Learning-Modell.
Speicherung. Ergebnisse und Rohereignisse werden in Datenbanken, Caches oder Data Lakes geschrieben, je nachdem, ob sie sofort, kurz danach oder für langfristige Analysen gebraucht werden.
Aktion und Auslieferung. Das Ergebnis erreicht sein Ziel: ein Live-Dashboard, einen Alarm, einen automatisierten Workflow, eine kundenseitige Oberfläche oder ein anderes System über eine Schnittstelle.
Schon die erste Stufe entscheidet oft über Erfolg oder Misserfolg. Echtzeitsysteme sind nur so gut wie die Daten, die man ihnen zuführt, und der Großteil dieser Daten kommt über Verbindungen zwischen Systemen. Gut gestaltete, sichere Schnittstellen sind dafür entscheidend. Deshalb investieren viele Teams früh in API-Entwicklung und Integration, damit Ereignisse sauber aus den Quellanwendungen in die Pipeline fließen, ohne fragile Notlösungen.
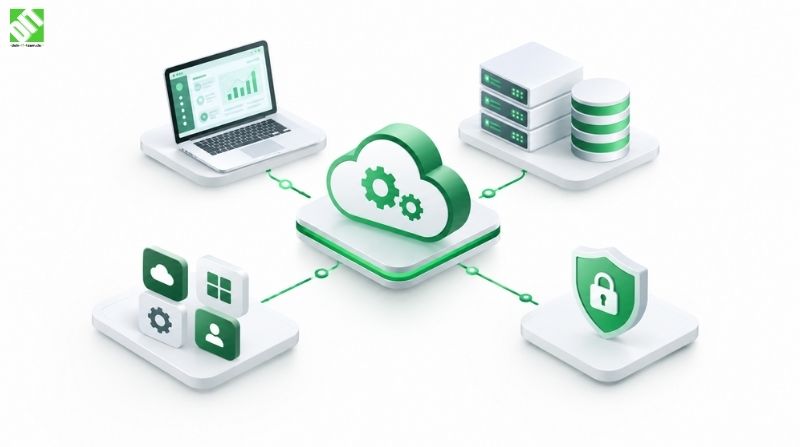
Zentrale Architekturkomponenten
Sie müssen keine Produktnamen auswendig kennen, um eine Echtzeit-Architektur zu verstehen. Es hilft, in Rollen zu denken.
| Komponente | Aufgabe | Typische Technologiekategorie |
| Datenquellen | Erzeugen Ereignisse | Anwendungen, Sensoren, Datenbanken, Zahlungssysteme |
| Message Broker oder Event-Streaming-Plattform | Empfängt, ordnet und verteilt Ereignisse | Verteilte Log- und Queue-Systeme |
| Stream-Processing-Engine | Transformiert und analysiert Ereignisse im Fluss | Stream-Processing-Frameworks |
| Serving- und Speicherschicht | Hält Ergebnisse für schnelle Abfragen und Langzeitanalysen bereit | In-Memory-Stores, Zeitreihendatenbanken, Data Lakes, Data Warehouses |
| Visualisierungs- und Aktionsschicht | Stellt Ergebnisse dar oder löst Aktionen aus | Dashboards, Alerting-Tools, Workflow-Engines |
Der konkrete Stack hängt von Datenvolumen, Latenzziel, Budget, bestehenden Systemen und den Fähigkeiten Ihres Teams ab. Eine universell beste Kombination gibt es nicht, und wer das behauptet, verkauft meist genau eine davon.
Ereignisgesteuerte Architektur
Die meisten modernen Echtzeitsysteme basieren auf Ereignissen. Ein Ereignis ist schlicht ein Datensatz darüber, dass etwas passiert ist: Eine Bestellung wurde aufgegeben, eine Temperatur hat einen Schwellenwert überschritten, ein Fahrer ist angekommen. Statt sich gegenseitig ständig zu fragen, ob es Neuigkeiten gibt, veröffentlichen Systeme Ereignisse, und interessierte Systeme abonnieren sie. Das senkt die Kopplung, skaliert besser und erleichtert es, später neue Verbraucher anzubinden, ohne Bestehendes umzubauen.
Stream Processing und Fensterung
Datenströme enden nie, deshalb können Sie nicht auf "alle Daten" warten, bevor Sie etwas berechnen. Stream-Prozessoren arbeiten stattdessen mit Zeitfenstern: etwa dem gleitenden Fünf-Minuten-Durchschnitt von Transaktionen oder der Anzahl fehlgeschlagener Logins pro Nutzer in den letzten sechzig Sekunden. Die Wahl der Fenstertypen und der Umgang mit verspätet oder in falscher Reihenfolge eintreffenden Ereignissen gehören zu den feineren Designentscheidungen in diesem Bereich.
Warum die Integration an erster Stelle steht
Eine Streaming-Plattform allein bringt wenig, wenn CRM, ERP und operative Datenbanken weiterhin über nächtliche Exporte miteinander sprechen. Die Verbindung dieser Systeme, sodass Daten in Bewegung bleiben, ist ein eigenes Thema, dessen Begründung wir in unserem Beitrag darüber, warum Unternehmen Echtzeit-Datenintegration brauchen, ausführlicher behandeln. Die Kurzfassung: Verarbeitungsgeschwindigkeit hilft nur, wenn die Daten den Prozessor überhaupt erreichen.
Vorteile der Echtzeit-Datenverarbeitung
Die Vorteile lassen sich leicht aufzählen, zählen aber nur dann, wenn sie an eine konkrete Entscheidung in Ihrem Unternehmen geknüpft sind.
Schnellere, besser fundierte Entscheidungen. Wer aktuelle Zustände statt der Zusammenfassung der Vorwoche sieht, kann reagieren, solange sich noch etwas ändern lässt. Ein Lagerengpass, der morgens auffällt, ist behoben, bevor der Nachmittagsandrang beginnt.
Weniger Risiko und Betrugsverluste. Verdächtige Aktivitäten können erkannt werden, während eine Transaktion noch läuft, und nicht erst Tage später bei einer Prüfung. Das gleiche Prinzip gilt für Sicherheitsereignisse und Compliance-Überwachung.
Bessere Kundenerfahrung. Live-Bestellverfolgung, korrekte Verfügbarkeitsanzeigen, sofortige Personalisierung und reaktionsschneller Support hängen alle von aktuellen Daten ab. Kunden merken, wenn Informationen veraltet sind, auch wenn sie nicht sagen können, woran es liegt.
Höhere betriebliche Effizienz. Kontinuierliche Überwachung deckt Engpässe, Anlagenabweichungen und Prozessfehler früh auf. Ein kleines Problem zu beheben ist fast immer günstiger, als sich von einem großen zu erholen.
Automatisierung, die wirklich funktioniert. Workflows, die auf Live-Ereignisse reagieren (Nachbestellung von Waren, Umleitung einer Sendung, Eskalation eines Tickets), ersetzen manuelles Nachsehen und verkürzen die Zeit zwischen "etwas ist passiert" und "jemand hat etwas unternommen".
Ein stärkeres Fundament für KI. Viele Machine-Learning-Anwendungen wie Empfehlungen, Anomalieerkennung und Bedarfsprognosen liefern bessere Ergebnisse, wenn Modelle mit aktuellen Signalen statt mit veralteten Momentaufnahmen arbeiten.
Anwendungsfälle der Echtzeit-Datenverarbeitung nach Branche
Die folgenden Beispiele sind illustrative Szenarien, die typische Einsatzweisen zeigen. Es handelt sich nicht um konkrete Kundenprojekte.
Finanzwesen und Banken
Kartentransaktionen können in Sekundenbruchteilen anhand von Verhaltensmustern bewertet werden. So kann ein System eine Zahlung freigeben, ablehnen oder zusätzlich absichern, bevor der Kunde die Bezahlseite verlässt. Auch Handelsplattformen, Risikoüberwachung und Geldwäscheprüfungen setzen auf Streaming-Daten.
Einzelhandel und E-Commerce
Die Live-Synchronisierung von Beständen verhindert Überverkäufe über Webshop, Marktplätze und Filialen hinweg. Dynamische Preisgestaltung, personalisierte Produktempfehlungen und Warenkorbabbruch-Trigger beruhen darauf, das Kundenverhalten im Moment des Geschehens auszulesen.
Logistik und Transport
Eine Flottenmanagement-Plattform verarbeitet kontinuierlich GPS-Positionen, Verkehrslage und Lieferstatus. Disponenten sehen, wo sich jedes Fahrzeug befindet, voraussichtliche Ankunftszeiten aktualisieren sich automatisch, und Routen lassen sich bei veränderter Lage anpassen. Dasselbe Muster gilt für Fahrtvermittlungs- und Mobilitäts-Apps, bei denen das Zusammenbringen von Fahrgästen und nahen Fahrern im Kern ein Streaming-Problem ist.
Fertigung und industrielles IoT
Sensoren an Produktionsanlagen senden alle paar Sekunden Schwingungs-, Temperatur- und Druckwerte. Ein Stream-Prozessor vergleicht sie mit Normalbereichen und schlägt Alarm, wenn ein Muster auf ein defektes Lager oder einen überhitzenden Motor hindeutet. Das ist die Grundlage der vorausschauenden Wartung und eines der klarsten Felder, in denen IoT-Entwicklung und Echtzeitverarbeitung Hand in Hand arbeiten, denn die Qualität des Ergebnisses hängt von zuverlässiger Gerätekonnektivität, Datenerfassung und Geräteverwaltung ab.
Gesundheitswesen
Geräte zur Fernüberwachung von Patienten können Vitalwerte an Ärzte streamen, mit automatischen Warnungen, sobald Messwerte den sicheren Bereich verlassen. Krankenhäuser nutzen Live-Daten außerdem für Bettenmanagement, Personaleinsatz und Gerätetracking. Weil Gesundheitsdaten sensibel sind, prägen Sicherheits- und Datenschutzanforderungen das Design von Anfang an.
Energie und Versorgung
Smart Meter und Netzsensoren liefern ständig Messwerte. Echtzeitanalysen helfen, Lasten auszugleichen, Ausfälle schnell zu erkennen und schwankende erneuerbare Erzeugung einzubinden.
Telekommunikation
Netzwerkdaten werden fortlaufend analysiert, um Überlastung, abgebrochene Verbindungen und ungewöhnlichen Datenverkehr zu erkennen. So können Betreiber eingreifen, bevor sich Kunden beschweren.
Herausforderungen der Echtzeit-Datenverarbeitung
Das ist der Teil, den Anbieterbroschüren gern überspringen. Echtzeitsysteme sind schwieriger zu bauen und zu betreiben als Batch-Systeme, und die Schwierigkeiten sind größtenteils vorhersehbar.
Zielkonflikt zwischen Latenz und Durchsatz. Niedrigere Latenz kostet in der Regel mehr Infrastruktur und Entwicklungsaufwand. Sie brauchen ein klares, geschäftlich begründetes Ziel statt des vagen Wunsches nach "so schnell wie möglich".
Datenqualität. Schlechte Daten bewegen sich genauso schnell wie gute. Doppelte Ereignisse, fehlende Felder, uneinheitliche Formate und Nachrichten in falscher Reihenfolge müssen in der Pipeline behandelt werden, denn es gibt keinen nächtlichen Bereinigungslauf, der Sie rettet.
Skalierbarkeit und Lastspitzen. Der Datenverkehr verläuft selten gleichmäßig. Ein Flash Sale, ein Marktereignis oder ein fehlerhaftes Gerät, das das System flutet, kann das Volumen binnen Sekunden vervielfachen. Die Architektur sollte ohne manuelles Eingreifen hoch- und herunterskalieren.
Fehlertoleranz und Konsistenz. Was passiert, wenn ein Knoten mitten in der Verarbeitung eines Ereignisses ausfällt? Teams müssen entscheiden, wie strikt sie verlorene oder doppelte Ergebnisse vermeiden wollen, und diese Entscheidung beeinflusst Design und Kosten erheblich.
Anbindung von Altsystemen. Ältere ERP-, CRM- und On-Premise-Datenbanken wurden nicht dafür gebaut, Ereignisse auszusenden. Sie anzubinden erfordert oft Change Data Capture, Adapter oder eine schrittweise Anwendungsmodernisierung.
Sicherheit und Compliance. Daten in Bewegung brauchen Verschlüsselung, Zugriffskontrolle, Protokollierung und einen sorgfältigen Umgang mit personenbezogenen Daten, besonders für Organisationen, die der DSGVO und ähnlichen Vorgaben unterliegen. Streaming entbindet nicht von Aufbewahrungs- und Löschpflichten.
Überwachung und Betrieb. Eine Pipeline, die unbemerkt stehen bleibt, ist schlimmer als eine, die laut ausfällt. Sie brauchen Observability für Verzögerungen, Fehlerraten, Durchsatz und Datenaktualität, dazu klare Zuständigkeiten für den Fall, dass nachts um drei etwas ausfällt.
Fachwissen und Kosten. Stream Processing ist eine Spezialdisziplin. Entwicklungsaufwand, Infrastrukturkosten und laufenden Support zu unterschätzen, gehört zu den häufigsten Gründen, warum Projekte ins Stocken geraten.
Echtzeit-Datenverarbeitung einführen: ein praktisches Vorgehen
Ein sinnvoller Rollout erfolgt schrittweise. Die gesamte Datenlandschaft auf einmal umzustellen, endet meist schlecht.
Mit einer Geschäftsfrage beginnen. Bestimmen Sie ein oder zwei Entscheidungen, die durch Verzögerung an Wert verlieren. "Zahlungsbetrug vor der Autorisierung erkennen" ist ein guter Startpunkt. "Echtzeitfähiger werden" ist keiner.
Die Latenzanforderung festlegen. Entscheiden Sie, welche Geschwindigkeit tatsächlich nützlich ist. Oft reichen Sekunden, und diese Wahl verändert die Kosten deutlich.
Datenquellen erfassen. Halten Sie fest, wo die relevanten Daten liegen, wie sie strukturiert sind, wie oft sie sich ändern und wer sie verantwortet.
Die Architektur wählen. Wählen Sie Streaming-, Verarbeitungs- und Speicherschicht anhand von Volumen, vorhandenen Kompetenzen, bestehender Infrastruktur und Wachstumsplänen.
Zuerst einen dünnen Durchstich bauen. Liefern Sie eine einzelne durchgängige Pipeline von der Quelle bis zur Aktion, bevor Sie erweitern. So zeigen sich Integrations- und Datenqualitätsprobleme früh.
Unter realistischer Last testen. Simulieren Sie Lastspitzen, Ausfälle und fehlerhafte Daten, nicht nur den Idealfall.
Absichern und überwachen. Richten Sie vor dem Go-live Verschlüsselung, Zugriffsrichtlinien, Alerting und Überwachung der Datenaktualität ein.
Iterieren. Ergänzen Sie Quellen, Verbraucher und Anwendungsfälle, sobald der erste seinen Wert bewiesen hat.
Kostenfaktoren
Einen seriösen Einheitspreis für ein Echtzeit-Datenverarbeitungsprojekt gibt es nicht, weil der Umfang enorm variiert. Die wichtigsten Kostentreiber sind:
Datenvolumen und Datengeschwindigkeit
Anzahl und Komplexität der Datenquellen
Latenzziele
Verarbeitungskomplexität, einschließlich Machine Learning
Integration in bestehende Systeme
Sicherheits- und Compliance-Anforderungen
Cloud- und Infrastrukturentscheidungen
Tests, Monitoring und laufende Wartung
Teamgröße und Expertise
Ein fokussierter Pilot mit einer Quelle und einem Ergebnis ist eine völlig andere Investition als eine unternehmensweite Event-Plattform. Die erste Phase sorgfältig abzugrenzen ist der beste Weg, Risiko und Budget unter Kontrolle zu halten.
Selbst bauen, zukaufen oder kombinieren
Verwaltete Cloud-Streaming-Dienste können die Time-to-Value verkürzen und den Betriebsaufwand senken. Individuelle Entwicklung bietet mehr Kontrolle über Logik, Integrationen und Benutzererlebnis. Viele Organisationen kombinieren beides: verwaltete Infrastruktur als Unterbau, darauf individuelle Anwendungen, Regeln und Workflows. Die richtige Balance hängt davon ab, wie spezifisch Ihre Anforderungen sind und wie viel Betriebsverantwortung Sie selbst tragen wollen.
Best Practices
Den ersten Anwendungsfall klein und messbar halten.
Von Anfang an auf Ausfälle auslegen: Wiederholversuche, Dead-Letter-Behandlung und Replay.
Ereignisse selbstbeschreibend gestalten, mit klaren Schemata und Versionierung.
Trennen, was in Echtzeit laufen muss und was Batch bleiben kann.
Datenqualitätsprüfungen als Teil der Pipeline verstehen, nicht als spätere Bereinigung.
Die Datenaktualität so genau überwachen wie die Verfügbarkeit.
Zuständigkeiten dokumentieren, damit für jeden Stream jemand verantwortlich ist.
Kosten regelmäßig prüfen, denn dauerhaft laufende Verarbeitung wächst leicht unbemerkt.
Wohin sich die Echtzeit-Datenverarbeitung entwickelt
Drei Entwicklungen sind besonders beobachtenswert. Erstens rückt KI näher an den Datenstrom: Modelle bewerten und klassifizieren Ereignisse beim Eintreffen, statt in Offline-Jobs. Zweitens wandert die Verarbeitung durch Edge Computing näher an die Quelle, sodass Geräte lokal filtern und handeln können, bevor sie Daten weiterleiten. Drittens verschwimmt die Grenze zwischen Streaming- und Analyseplattformen zunehmend, was es leichter macht, Live- und Historiendaten gemeinsam abzufragen. Nichts davon ersetzt solide Grundlagen: saubere Daten, eine durchdachte Architektur und klare Geschäftsziele.
Fazit
Bei Echtzeit-Datenverarbeitung geht es nicht um Geschwindigkeit um ihrer selbst willen. Es geht darum, die Lücke zwischen einem Ereignis und einer sinnvollen Reaktion Ihres Unternehmens zu schließen. Am meisten profitieren Unternehmen, die mit einer konkreten Entscheidung beginnen, ein realistisches Latenzziel setzen, zuerst Datenquellen und Integrationen in Ordnung bringen und dann schrittweise ausbauen.
Die Herausforderungen sind real: Datenqualität, Skalierung, Sicherheit, Altsysteme und betriebliche Disziplin. Mit guter Planung lassen sie sich beherrschen. Wenn Sie gerade Datenquellen erfassen, zwischen verwalteten und individuellen Komponenten abwägen oder klären, wie eine Streaming-Pipeline an Ihre bestehenden Plattformen anschließen soll, ist ein durchdachter Ansatz für Cloud-Integration oft das, was die Architektur langfristig skalierbar und wartbar hält.
Wenn Sie eine zweite Meinung dazu wünschen, wo sich Echtzeit-Datenverarbeitung in Ihrem Unternehmen auszahlt, können Sie Ihr Projekt mit dem DEIN IT TEAM besprechen und Ziele, Systeme und Rahmenbedingungen durchgehen, bevor Sie sich auf irgendetwas festlegen.
Häufig gestellte Fragen
Was ist Echtzeit-Datenverarbeitung einfach erklärt?
Es ist die kontinuierliche Verarbeitung von Daten in dem Moment, in dem sie entstehen, sodass Ergebnisse in Millisekunden oder Sekunden statt Stunden vorliegen. Stellen Sie sich eine Live-Betrugsprüfung bei einer Kartenzahlung vor, im Gegensatz zu einem Bericht, der erst am nächsten Tag geprüft wird.
Was ist der Unterschied zwischen Echtzeit- und Batch-Verarbeitung?
Bei der Batch-Verarbeitung werden Daten gesammelt und in geplanten Gruppen verarbeitet, die Ergebnisse kommen entsprechend später. Die Echtzeit-Verarbeitung behandelt jedes Ereignis beim Eintreffen. Batch eignet sich für große, nicht dringende Datenmengen, Echtzeit für Situationen, in denen Verzögerungen den Wert mindern.
Was ist der Unterschied zwischen Echtzeit und Near-Realtime?
Echtzeit bedeutet in der Regel Reaktionen im Bereich von Millisekunden bis wenigen Sekunden. Near-Realtime erlaubt eine Verzögerung von einigen Sekunden bis wenigen Minuten, häufig durch Micro-Batches. Für viele Business-Dashboards genügt Near-Realtime völlig.
Welche Beispiele gibt es für Echtzeit-Datenverarbeitung?
Typische Beispiele sind Betrugserkennung bei Zahlungen, Live-GPS-Ortung in Flotten- und Fahrtvermittlungs-Apps, Bestandsaktualisierungen über Onlineshops hinweg, vorausschauende Wartung anhand von Maschinensensoren und die Fernüberwachung von Patienten.
Welche Branchen profitieren am meisten von Echtzeit-Datenverarbeitung?
Finanzwesen, Einzelhandel und E-Commerce, Logistik, Fertigung, Gesundheitswesen, Energie und Telekommunikation profitieren stark, vor allem weil ihre Entscheidungen von sich schnell ändernden Bedingungen abhängen.
Was kostet ein Echtzeit-Datenverarbeitungssystem?
Das hängt von Datenvolumen, Anzahl der Quellen, Latenzzielen, Integrationen, Sicherheitsanforderungen und Infrastrukturentscheidungen ab. Ein enger Pilot kostet deutlich weniger als eine unternehmensweite Plattform, der Umfang ist also die größte Variable.
Lässt sich Echtzeit-Datenverarbeitung mit Altsystemen nutzen?
Ja, in der Regel jedoch mit zusätzlichem Aufwand. Techniken wie Change Data Capture, Adapter und Schnittstellen erlauben es älteren Systemen, Ereignisströme zu speisen, ohne vollständig ersetzt zu werden. Manche Unternehmen modernisieren sie zusätzlich schrittweise.
Ist Echtzeit-Datenverarbeitung sicher?
Sie kann es sein, wenn Sicherheit von Anfang an eingeplant wird. Dazu gehören Verschlüsselung bei Übertragung und Speicherung, Zugriffskontrollen, Audit-Protokolle und ein sorgfältiger Umgang mit personenbezogenen Daten, um Vorgaben wie die DSGVO zu erfüllen.
Braucht jedes Unternehmen Echtzeit-Datenverarbeitung?
Nein. Sie lohnt sich, wenn eine verspätete Entscheidung Geld kostet, das Risiko erhöht oder die Kundenerfahrung verschlechtert. Für viele Reporting-Anforderungen sind Batch oder Near-Realtime einfacher und günstiger.
Wie lange dauert die Einführung?
Ein fokussierter Pilot mit einem einzelnen Anwendungsfall lässt sich oft in Wochen bis wenigen Monaten umsetzen, breitere Plattformen dauern länger. Der Zeitrahmen hängt von Integrationskomplexität, Datenqualität sowie Freigabe- und Sicherheitsanforderungen ab.