
Datenqualitätsmanagement: Best Practices für korrekte Geschäftsdaten
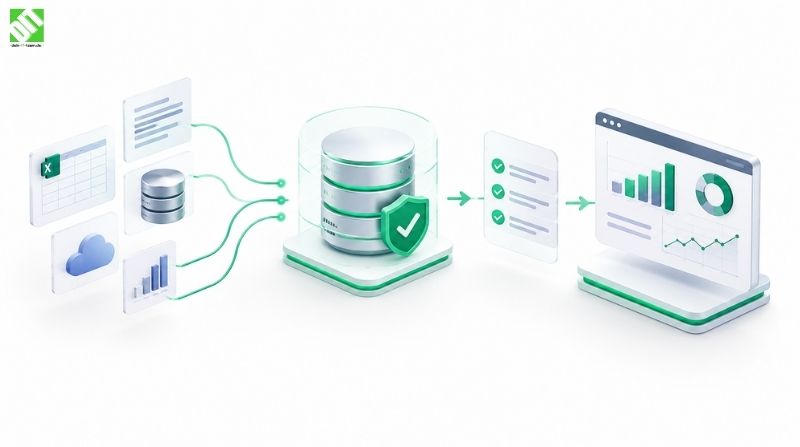
Datenqualitätsmanagement erklärt: Best Practices für korrekte, konsistente und verlässliche Geschäftsdaten, von Profiling bis Automatisierung.
Die meisten Unternehmen bemerken ein Datenproblem erst, wenn es sie etwas kostet. Ein Vertriebsbericht, der nicht zur Buchhaltung passt. Ein Kunde, der dieselbe E-Mail dreimal bekommt. Ein Lagerbestand, der 40 Stück ausweist, obwohl das Regal leer ist. Jedes dieser Beispiele wirkt wie eine Kleinigkeit, doch zusammen untergraben sie das Vertrauen in jedes Dashboard und jede Entscheidung, die auf diesen Daten beruht.
Datenqualitätsmanagement beugt genau dem vor. Es umfasst die Praktiken, Rollen, Regeln und Werkzeuge, mit denen ein Unternehmen seine Daten korrekt, vollständig, konsistent und nutzbar hält. Dieser Artikel erklärt, was Datenqualitätsmanagement beinhaltet, woher schlechte Daten kommen, welche Best Practices in der Praxis funktionieren und wie Sie einen Prozess aufbauen, der über eine einmalige Bereinigung hinaus Bestand hat.
Was ist Datenqualitätsmanagement?
Datenqualitätsmanagement (DQM) ist der fortlaufende Prozess, die Qualität der Daten eines Unternehmens zu definieren, zu messen, zu überwachen und zu verbessern, damit sie für ihren Verwendungszweck geeignet sind.
Zwei Teile dieser Definition sind wichtig. Erstens „fortlaufend“: Datenqualität ist kein Projekt, das man abschließt. Daten veralten, Systeme ändern sich, und Menschen erfassen Informationen auf unterschiedliche Weise. Zweitens „für den Verwendungszweck geeignet“: Derselbe Datensatz kann für einen monatlichen Trendbericht völlig ausreichen und für die Rechnungsstellung unbrauchbar sein. Qualität wird immer an einem Zweck gemessen.
Datenqualitätsmanagement umfasst in der Regel diese Aktivitäten:
Qualitätsstandards und Geschäftsregeln für wichtige Daten festlegen
Daten profilieren, um ihren aktuellen Zustand zu verstehen
Daten bei der Erstellung oder beim Import validieren
Bestehende Datensätze bereinigen und standardisieren
Die Qualität im Zeitverlauf mit messbaren Kennzahlen überwachen
Verantwortung und Zuständigkeiten festlegen
Die Ursachen wiederkehrender Fehler beheben
Es überschneidet sich mit Data Governance, ist aber nicht dasselbe. Governance legt die Richtlinien, Rollen und Entscheidungsbefugnisse rund um Daten fest. Datenqualitätsmanagement sorgt dafür, dass aus diesen Richtlinien messbare Ergebnisse im Tagesgeschäft werden.
Warum Datenqualitätsmanagement für Unternehmen wichtig ist
Schlechte Daten kündigen sich selten an. Sie zeigen sich als Mehrarbeit, langsamere Entscheidungen und schleichendes Misstrauen.
Entscheidungen werden schwächer. Prognosen, Preismodelle und Kapazitätsplanung gehen davon aus, dass die Eingangsdaten stimmen. Wenn doppelte Kundendatensätze die Kundenzahl aufblähen, ist jede Kennzahl pro Kunde verzerrt.
Abläufe werden langsamer. Teams verbringen Stunden damit, Tabellen abzugleichen, Adressen zu korrigieren und fehlenden Feldern nachzujagen. Ein Großteil dieser Arbeit bleibt unsichtbar, weil sie im normalen Arbeitsalltag untergeht.
Das Kundenerlebnis leidet. Falsche Namen, veraltete Kontaktdaten und nicht passende Bestellhistorien sind für Kunden sichtbar, und sie merken sich das.
Das Compliance-Risiko steigt. Vorschriften wie die DSGVO stellen Anforderungen an die Richtigkeit personenbezogener Daten und daran, dass bekannt ist, wo sie liegen. Wer den Datensatz einer Person nicht zuverlässig findet und korrigiert, kann auch Auskunfts-, Berichtigungs- und Löschanfragen nicht zuverlässig bearbeiten.
KI- und Analyseprojekte bleiben hinter den Erwartungen zurück. Modelle des maschinellen Lernens lernen aus dem, was sie bekommen. Schlechte Trainingsdaten führen zu unzuverlässigen Vorhersagen, und die Ursache wird oft beim Modell statt bei den Daten gesucht.
Die zentralen Dimensionen der Datenqualität
Was man nicht beschreiben kann, lässt sich nicht verbessern. Datenqualität wird üblicherweise in Dimensionen zerlegt, die sich jeweils einzeln messen lassen.
| Dimension | Bedeutung | Beispiel für einen Mangel |
| Richtigkeit | Die Daten bilden den realen Sachverhalt korrekt ab | Eine Kundentelefonnummer enthält eine falsche Ziffer |
| Vollständigkeit | Erforderliche Werte sind vorhanden | Bestellungen ohne Lieferadresse |
| Konsistenz | Dasselbe Faktum stimmt systemübergreifend überein | Der Kundenstatus lautet im CRM „aktiv“ und in der Buchhaltung „geschlossen“ |
| Aktualität | Die Daten sind für den Zweck aktuell genug | Lagerbestände werden für einen Live-Webshop nur einmal täglich aktualisiert |
| Gültigkeit | Die Daten entsprechen dem geforderten Format und den Regeln | Ein Datum wie 31.02.2026 |
| Eindeutigkeit | Jede Entität kommt nur einmal vor | Derselbe Lieferant ist in drei Schreibweisen gespeichert |
| Integrität | Beziehungen zwischen Datensätzen bleiben intakt | Eine Rechnung verweist auf eine Kunden-ID, die nicht mehr existiert |
Nicht jede Dimension ist für jeden Datensatz gleich wichtig. Bei einer Zahlungstabelle sind Richtigkeit und Integrität entscheidend. In der Marketinganalyse verursachen Vollständigkeit und Eindeutigkeit im Alltag oft mehr Probleme. Zu gutem DQM gehört deshalb auch, pro Datenbereich zu entscheiden, welche Dimensionen am wichtigsten sind.
Woher schlechte Datenqualität kommt
Bevor man Werkzeuge auswählt oder Regeln schreibt, sollte man wissen, wie fehlerhafte Daten überhaupt in die Systeme gelangen. Wer Datensätze bereinigt, ohne die Quelle zu verstehen, bereinigt sie im nächsten Quartal erneut.
Manuelle Dateneingabe. Tippfehler, übersprungene Felder und uneinheitliche Formate sind der Klassiker. Freitextfelder sind besonders riskant, denn „München“, „Muenchen“ und „Munchen“ sind für einen Menschen alle gültig, für eine Datenbank aber drei verschiedene Werte.
Getrennte Systeme. Wenn CRM, ERP, Onlineshop und Finanzsoftware jeweils eine eigene Version eines Kunden oder Produkts führen, laufen sie auseinander. Jeder manuelle Export und Re-Import ist eine weitere Gelegenheit für Fehler.
Schwache Integrationen. Punkt-zu-Punkt-Verbindungen, die in Eile gebaut wurden, lassen Validierung, Transformationsregeln und Fehlerbehandlung oft aus. Eine gut gestaltete Schicht für API-Entwicklung und -Integration kann Formate durchsetzen, fehlerhafte Nachrichten abweisen und Systeme über einen kontrollierten Weg synchron halten, statt über ein Geflecht einmaliger Skripte.
Fusionen, Migrationen und Altsysteme. Wer Datenbestände aus unterschiedlichen Quellen mit verschiedenen Strukturen zusammenführt, erzeugt fast immer Dubletten und Zuordnungsfehler. Altsysteme speichern Daten außerdem mitunter in Formaten, die kein modernes Werkzeug erwartet.
Fehlende Verantwortung. Wenn niemand für einen Datenbestand zuständig ist, behebt auch niemand die Fehler. Sie werden umgangen statt gelöst.
Natürlicher Verfall. Menschen wechseln den Job, ziehen um, ändern ihren Namen, und Firmen schließen. Selbst perfekt erfasste Daten veralten, wenn sie nicht aufgefrischt werden.
Best Practices im Datenqualitätsmanagement
Die folgenden Praktiken sind grob in der Reihenfolge geordnet, in der die meisten Unternehmen sie einführen sollten. Sie müssen nicht alle gleichzeitig umgesetzt werden.
1. Klare Verantwortlichkeiten festlegen
Jeder wichtige Datenbereich (Kunden, Produkte, Lieferanten, Finanzen) braucht einen benannten fachlichen Verantwortlichen. Das ist meist jemand aus dem Fachbereich, nicht aus der IT. Diese Person entscheidet, was „gut“ bedeutet, genehmigt die Regeln und ist Ansprechpartner, wenn die Qualität sinkt.
Viele Teams benennen zusätzlich Data Stewards, die sich um die tägliche Klärung von Problemen kümmern. Die IT unterstützt mit Werkzeugen und Infrastruktur, aber die Bedeutung der Daten verantwortet der Fachbereich.
2. Qualitätsstandards an Geschäftsergebnisse knüpfen
„Wir brauchen sauberere Daten“ ist kein Standard. Ein Standard ist konkret: „Jeder aktive Kundendatensatz muss eine gültige E-Mail-Adresse, einen Ländercode und eine eindeutige Kunden-ID enthalten.“ Formulieren Sie Regeln zuerst in einfacher Sprache und übersetzen Sie sie danach in technische Prüfungen.
Ein nützlicher Test: Lässt sich eine Regel nicht mit einer realen geschäftlichen Folge verbinden, etwa gescheiterten Lieferungen, Rechnungsstreitigkeiten oder Compliance-Risiken, hat sie wahrscheinlich keine Priorität.
3. Daten profilieren, bevor man sie korrigiert
Datenprofilierung bedeutet, Datensätze zu analysieren, um zu sehen, was tatsächlich in ihnen steckt: Werteverteilungen, Anteile leerer Felder, Anzahl der Dubletten, Formatmuster und Ausreißer. Das überrascht die Beteiligten fast immer. Felder, die als zu 99 % vollständig galten, sind in Wahrheit zu 70 % gefüllt, oder ein „Pflichtfeld“ ist voller Platzhalter wie „k. A.“ und „xxx“.
Das Profiling liefert eine Ausgangsbasis. Ohne sie lässt sich nicht belegen, dass sich etwas verbessert hat.
4. Bereits bei der Eingabe validieren
Vorbeugen ist günstiger als Korrigieren. Einen ungültigen Wert beim Tippen oder Importieren abzufangen kostet fast nichts; ihn sechs Monate später in einem Bericht zu finden, kostet deutlich mehr.
Wirksame Kontrollen an der Eingabe sind unter anderem:
Auswahllisten und kontrollierte Vokabulare statt Freitext
Format- und Bereichsprüfungen (Postleitzahlen, Datumsangaben, USt-IdNr.)
Erzwingen von Pflichtfeldern
Dublettenerkennung beim Anlegen eines neuen Datensatzes
Validierung in APIs und Importjobs, nicht nur in Benutzeroberflächen
Der letzte Punkt wird häufig übersehen. Ein Formular kann sauber validiert sein, während ein nächtlicher Importjob ohne jede Prüfung direkt in die Datenbank schreibt.
5. Bestehende Daten standardisieren und bereinigen
Sobald der Zustand der Daten bekannt ist, sollten Sie sie systematisch bereinigen. Typische Aufgaben:
Formate vereinheitlichen (Datumsangaben, Telefonnummern, Adressen, Einheiten)
Dubletten entfernen oder zusammenführen
Bekannte Fehler anhand vertrauenswürdiger Referenzdaten korrigieren
Lücken füllen, wo verlässliche Quellen existieren
Veraltete Datensätze archivieren oder löschen
Führen Sie ein Änderungsprotokoll darüber, was warum geändert wurde. Automatisierte Bereinigung ist leistungsfähig, aber falsch zusammengeführte Datensätze können wertvolle Informationen zerstören. Riskante Zusammenführungen sollten daher von Menschen geprüft werden.
6. Eine zentrale Wahrheitsquelle für Stammdaten schaffen
Stammdaten sind die zentralen Referenzinformationen, auf die ein Unternehmen angewiesen ist: Kunden, Produkte, Lieferanten, Standorte, Mitarbeitende. Stammdatenmanagement (Master Data Management, MDM) heißt, für jede Entität festzulegen, welches System maßgeblich ist, und dafür zu sorgen, dass andere Systeme diese Version nutzen, statt eigene zu pflegen.
Sie brauchen keine MDM-Plattform in Konzerngröße, um anzufangen. Schon eine klare Regel wie „Kundendaten werden ausschließlich im CRM angelegt und bearbeitet und von dort an andere Systeme verteilt“ beseitigt eine große Quelle für Inkonsistenzen.
7. Die Qualität kontinuierlich überwachen
Eine einmalige Bereinigung verfällt innerhalb weniger Monate. Richten Sie automatisierte Prüfungen ein, die nach Zeitplan oder bei jedem Datenladevorgang laufen, und stellen Sie die Ergebnisse in einem Dashboard dar, das tatsächlich angesehen wird. Warnungen sollten an den Datenverantwortlichen gehen und nicht in einem gemeinsamen Postfach untergehen.
8. Ursachen beheben, nicht nur Symptome
Wenn ein Fehler auftritt, fragen Sie, wo er ins System gelangt ist. Kehrt dasselbe Problem immer wieder, gehört die Lösung weiter vorn in die Kette: eine Validierungsregel, ein geändertes Formular, ein korrigiertes Mapping in der Integration oder eine Schulungslücke. Eine einfache und bewährte Methode: Jedes wiederkehrende Datenproblem mit seiner Ursache protokollieren und nachverfolgen, wie viele dauerhaft gelöst und wie viele immer wieder bereinigt wurden.
9. Die Menschen schulen, die mit den Daten arbeiten
Mitarbeitende, die Daten erfassen, müssen verstehen, warum es die Regeln gibt. Einem Vertriebsteam zu zeigen, wie ein fehlendes Feld zu einer gescheiterten Rechnung führt, wirkt weit besser als ein Richtliniendokument. Halten Sie Schulungen kurz, konkret und nah an den Systemen, die tatsächlich im Einsatz sind.
So bauen Sie einen Datenqualitätsmanagement-Prozess auf
Wenn Sie bei null anfangen, funktioniert diese Reihenfolge für die meisten Organisationen:
Einen Startpunkt mit hohem Nutzen wählen. Nehmen Sie einen Datenbereich, der mit einem klaren Geschäftsproblem verbunden ist, etwa Kundendaten für die Rechnungsstellung. Versuchen Sie nicht, alles auf einmal zu lösen.
Kritische Datenelemente identifizieren. Listen Sie die Felder auf, die bei Fehlern echten Schaden anrichten.
Den Ist-Zustand profilieren. Messen Sie Vollständigkeit, Dubletten, Gültigkeit und Konsistenz, um eine Ausgangsbasis zu schaffen.
Regeln und Schwellenwerte definieren. Legen Sie gemeinsam mit dem Fachbereich fest, was akzeptable Qualität bedeutet, zum Beispiel „Dublettenquote unter 1 %“.
Präventive Kontrollen umsetzen. Ergänzen Sie Validierung an Eingabestellen, Importen und Integrationen.
Bestehende Daten bereinigen. Priorisieren Sie Datensätze, die aktiv genutzt werden.
Überwachen und berichten. Verfolgen Sie die vereinbarten Kennzahlen und besprechen Sie sie regelmäßig mit dem Datenverantwortlichen.
Ursachen untersuchen und beheben. Speisen Sie die Erkenntnisse in Regeln, Systeme und Schulungen zurück.
Auf den nächsten Bereich ausweiten. Nutzen Sie Vorgehen, Rollen und Werkzeuge erneut.
Teams, die so vorgehen, sehen in einem Datenbereich oft schon nach wenigen Wochen sichtbare Verbesserungen. Das schafft die interne Unterstützung, die für die Fortsetzung nötig ist.
Datenqualität und Integrationsarchitektur
Ein großer Teil der Datenqualitätsprobleme ist in Wahrheit ein Integrationsproblem. Wenn Daten stapelweise, mit wenig Validierung und langen Verzögerungen zwischen Systemen wandern, häufen sich Abweichungen zwischen den Läufen an. Zwei Teams betrachten im selben Moment denselben Kunden und sehen unterschiedliche Fakten.
Ein Wechsel zu ereignisgesteuerter oder echtzeitnaher Synchronisation verkleinert diese Lücke. Er zwingt außerdem dazu, klare Datenverträge zwischen Systemen zu definieren: welche Felder erforderlich sind, welche Formate akzeptiert werden und was passiert, wenn eine Nachricht die Validierung nicht besteht. Die Hintergründe dazu werden ausführlicher in diesem Beitrag erläutert: warum Unternehmen Echtzeit-Datenintegration brauchen.
Einige Architekturprinzipien helfen unabhängig von der konkreten Technologie:
An Systemgrenzen validieren. Prüfen Sie Daten immer, wenn sie von einem System in ein anderes wechseln, nicht nur bei der Eingabe durch Menschen.
Schemas und Verträge nutzen. Explizite Definitionen von Struktur und Pflichtwerten machen Änderungen, die etwas zerbrechen, frühzeitig sichtbar.
Fehler sichtbar behandeln. Abgewiesene Datensätze gehören mit Begründung in eine Prüfwarteschlange und sollten nicht stillschweigend verschwinden.
Datenherkunft nachvollziehbar halten. Wissen Sie, woher jede Information stammt und was sie verändert hat, damit sich Fehler zurückverfolgen lassen.
Einen einzigen Schreibweg pro Entität bevorzugen. Wenn fünf Systeme denselben Kundendatensatz bearbeiten können, sind Konflikte garantiert.
Datenqualitätsmanagement automatisieren
Manuelle Prüfungen skalieren nicht. Automatisierung sorgt dafür, dass Qualitätsregeln konsistent für jeden Datensatz laufen, ohne dass jemand daran denken muss.
Regelbasierte Validierung und Bereinigung. Formatprüfungen, Dublettenabgleich, Abfragen gegen Referenzdaten und Standardisierungsregeln lassen sich bei der Datenaufnahme oder nach Zeitplan automatisch ausführen.
Workflow- und Prozessautomatisierung. Viele fehlerhafte Daten entstehen durch repetitive manuelle Arbeit, etwa wenn Werte aus E-Mails, PDFs oder Altsystem-Masken in ein anderes System übertragen werden. Robotic Process Automation kann solche wiederkehrenden, regelbasierten Übertragungen übernehmen, dabei jedes Mal dieselben Validierungsschritte anwenden und Ausnahmen an eine Person melden, statt Fehler durchrutschen zu lassen.
Maschinelles Lernen für Anomalien. Statistische Verfahren und maschinelles Lernen erkennen Werte, die im Vergleich zu historischen Mustern ungewöhnlich wirken: ein plötzlicher Anstieg leerer Felder, ein Bestellwert weit außerhalb des Normalbereichs oder ein Lieferantenname, der wahrscheinlich eine Variante eines bestehenden ist. Diese Methoden ergänzen feste Regeln; sie sind gut darin, Probleme zu finden, für die man keine Regel geschrieben hat.
Automatisierung braucht Leitplanken. Automatische Korrekturen benötigen Protokollierung, Schwellenwerte für die Prüfung durch Menschen und die Möglichkeit, Änderungen zurückzunehmen.
Datenqualität messen: Kennzahlen, auf die es ankommt
Wählen Sie eine kleine Zahl von Kennzahlen, die mit Geschäftsergebnissen verknüpft sind. Gängig sind:
| Kennzahl | Typische Berechnung |
| Vollständigkeitsquote | Datensätze mit allen Pflichtfeldern / Gesamtzahl der Datensätze |
| Dublettenquote | Doppelte Datensätze / Gesamtzahl der Datensätze |
| Gültigkeitsquote | Datensätze, die Format- und Regelprüfungen bestehen / Gesamtzahl der Datensätze |
| Konsistenzquote | Übereinstimmende Werte zwischen Systemen / Gesamtzahl der verglichenen Datensätze |
| Aktualität | Durchschnittliches Alter der Daten oder Verzögerung zwischen realer Änderung und Aktualisierung |
| Zeit bis zur Fehlerbehebung | Zeit von der Erkennung bis zur bestätigten Behebung |
| Auswirkung im Geschäft | Gescheiterte Lieferungen, abgelehnte Rechnungen oder Rücksendungen durch Datenfehler |
Rein technische Werte können in die Irre führen. Eine Vollständigkeit von 98 % klingt hervorragend, bis man erfährt, dass die fehlenden 2 % die wertvollsten Kunden betreffen. Stellen Sie die Prozentwerte deshalb immer einer Kennzahl zur geschäftlichen Auswirkung gegenüber, damit die Führungsebene sieht, warum die Zahl zählt.
Data-Quality-Tools und Technologie auswählen
Beginnen Sie nicht mit einem Produktnamen, sondern mit den Fähigkeiten, die Sie brauchen. Typische Kategorien:
Profiling-Werkzeuge zur Beurteilung des aktuellen Zustands
Werkzeuge für Bereinigung und Matching zur Standardisierung und Deduplizierung
Validierungsframeworks, die Regelprüfungen innerhalb von Datenpipelines ausführen
MDM-Plattformen für maßgebliche Entitätsdatensätze
Datenkatalog- und Lineage-Werkzeuge für Auffindbarkeit und Nachvollziehbarkeit
Monitoring- und Observability-Werkzeuge zur Erkennung von Anomalien und Pipeline-Ausfällen
Ob Sie eine Plattform kaufen, vorhandene Systeme erweitern oder eigene Komponenten entwickeln, hängt von mehreren Faktoren ab: wie viele Systeme Sie integrieren, wie komplex Ihre Matching-Regeln sind, welche regulatorischen Anforderungen gelten, welche Cloud- und Datenbankinfrastruktur bereits vorhanden ist, welche internen Kompetenzen und welches Budget zur Verfügung stehen. Organisationen mit ungewöhnlichen Datenmodellen oder enger Verzahnung mit ERP- und CRM-Systemen fahren oft mit einer Mischung am besten: Standardwerkzeuge für generische Aufgaben und individuelle Logik dort, wo die Geschäftsregeln spezifisch sind.
Häufige Fehler im Datenqualitätsmanagement
Es als IT-Projekt behandeln. Wenn der Fachbereich die Regeln nicht verantwortet, muss die IT raten, was „korrekt“ bedeutet.
Bereinigen ohne Vorbeugung. Wer die Datenbank säubert, aber die Eingabestellen unverändert lässt, bekommt garantiert dasselbe Chaos zurück.
Alles auf einmal lösen wollen. Breit angelegte Programme versanden. Enge, sichtbare Erfolge halten den Schwung aufrecht.
Unstrukturierte und externe Daten ignorieren. Dokumente, E-Mails und Feeds von Dritten bergen ebenfalls Qualitätsrisiken, und sie werden leicht übersehen.
Sich zu sehr auf Werkzeuge verlassen. Software setzt Regeln durch; sie kann nicht entscheiden, wie die Regeln lauten sollen.
Keine Rückmeldeschleife. Wenn Datennutzer Fehler nicht einfach melden können, bleiben Probleme verborgen, bis sie Schaden anrichten.
Ein praktisches Beispiel
Das folgende Beispiel ist illustrativ und kein Kundenprojekt von DEIN IT TEAM.
Stellen Sie sich einen mittelständischen Händler vor, der über einen Webshop und den Außendienst verkauft. Die Kundendaten liegen an drei Orten: im ERP, im CRM und auf der E-Commerce-Plattform. Mit der Zeit erscheint derselbe Kunde in jedem System mit leicht abweichendem Namen und abweichender Adresse. Rechnungen gehen an alte Adressen, und Vertriebsmitarbeitende sprechen mitunter Kunden an, die gerade eine offene Reklamation haben.
Ein sinnvolles DQM-Vorgehen könnte so aussehen:
Die Kundendatensätze in allen drei Systemen profilieren, um Dubletten und fehlende Felder zu messen.
Das CRM als maßgebliche Quelle für Kundenidentität und Kontaktdaten festlegen.
Adressformate standardisieren und Dubletten zusammenführen, mit manueller Prüfung bei unklaren Treffern.
Validierung bei der Registrierung im Webshop und in den Erfassungsmasken des Vertriebs ergänzen.
Änderungen aus dem CRM über eine kontrollierte Integrationsschicht in die anderen Systeme synchronisieren.
Dublettenquote, zurückgegangene Rechnungen und adressbedingte Lieferfehler monatlich verfolgen.
Nichts davon ist exotisch. Der Nutzen entsteht dadurch, dass geklärt ist, wem die Daten gehören, dass Regeln dort greifen, wo Daten entstehen, und dass Ergebnisse gemessen werden.
Fazit
Beim Datenqualitätsmanagement geht es weniger um perfekte als um verlässliche Daten: Informationen, die Ihre Teams nutzen können, ohne sie anzuzweifeln. Unternehmen, die es gut machen, haben ähnliche Gewohnheiten. Sie legen Verantwortung fest, definieren Standards in geschäftlichen Begriffen, verhindern Fehler an der Quelle, überwachen kontinuierlich und beheben Ursachen, statt Bereinigungen zu wiederholen.
Wenn Sie am Anfang stehen, wählen Sie einen Datenbereich mit echtem Geschäftsbezug, messen Sie, wo er heute steht, und setzen Sie Validierung dort an, wo die Daten entstehen. Darauf aufbauend lassen sich Automatisierung und intelligentere Erkennung deutlich leichter ergänzen, etwa KI-gestützte Anomalieerkennung und maschinelles Lernen, die lernen, was normal aussieht, und melden, was nicht ins Muster passt.
Wenn Ihre Daten über ERP, CRM, Cloud und Altsysteme verteilt liegen und Sie nicht sicher sind, wo die Qualitätsprobleme beginnen, kann ein kurzes fachliches Gespräch oft Klarheit schaffen. Sprechen Sie mit DEIN IT TEAM über Ihr Projekt, um zu klären, wie ein praxistauglicher Ansatz für Datenqualität in Ihrer Umgebung aussehen könnte.
Sprechen Sie mit unserem Business Manager oder fordern Sie jetzt ein kostenloses Angebot an!
Häufig gestellte Fragen
Was ist Datenqualitätsmanagement in einfachen Worten?
Datenqualitätsmanagement ist die fortlaufende Praxis, Geschäftsdaten korrekt, vollständig, konsistent und nutzbar zu halten. Es verbindet Regeln, Verantwortlichkeiten, Monitoring und Werkzeuge, damit Menschen den Daten vertrauen können, auf die sie sich stützen.
Was sind die wichtigsten Dimensionen der Datenqualität?
Am häufigsten genutzt werden Richtigkeit, Vollständigkeit, Konsistenz, Aktualität, Gültigkeit, Eindeutigkeit und Integrität. Meist priorisieren Organisationen die wenigen Dimensionen, die für einen bestimmten Datensatz am wichtigsten sind.
Was ist der Unterschied zwischen Datenqualität und Data Governance?
Data Governance legt Richtlinien, Rollen und Entscheidungsbefugnisse für den Umgang mit Daten fest. Datenqualitätsmanagement setzt diese Richtlinien in der Praxis um, indem es misst, überwacht und verbessert, wie gut die Daten tatsächlich sind. Am besten funktionieren beide gemeinsam.
Wie misst man Datenqualität?
Mit Kennzahlen, die den einzelnen Dimensionen zugeordnet sind, etwa Vollständigkeitsquote, Dublettenquote, Gültigkeitsquote und systemübergreifende Konsistenz. Ergänzen Sie Messgrößen zur geschäftlichen Auswirkung, etwa gescheiterte Lieferungen oder Rechnungskorrekturen, damit die Zahlen reale Folgen widerspiegeln.
Wie oft sollte die Datenqualität geprüft werden?
Kritische Daten sollten kontinuierlich validiert werden, bei der Eingabe und bei jeder Integration oder jedem Ladevorgang. Umfassendere Qualitätsreviews, einschließlich Trendberichten und Ursachenanalysen, finden je nach Änderungsgeschwindigkeit der Daten meist monatlich oder quartalsweise statt.
Was verursacht schlechte Datenqualität?
Häufige Ursachen sind manuelle Eingabefehler, getrennte Systeme, schwache Integrationen, Systemmigrationen, fehlende Datenverantwortung und der natürliche Verfall von Daten, wenn sich Menschen und Unternehmen verändern.
Lässt sich Datenqualitätsmanagement automatisieren?
Weitgehend ja. Validierung, Standardisierung, Dublettenerkennung und Monitoring lassen sich automatisieren, und maschinelles Lernen kann ungewöhnliche Muster erkennen. Bei unklaren Fällen und riskanten Korrekturen bleibt die Prüfung durch Menschen wichtig.
Brauchen auch kleine und mittlere Unternehmen Datenqualitätsmanagement?
Ja, allerdings kann es schlank ausfallen. Ein kleines Unternehmen erzielt gute Ergebnisse, wenn es Datenverantwortliche benennt, wichtige Formulare um Validierung ergänzt und ein System als maßgebliche Quelle für Kunden- und Produktdaten festlegt.
Sollte ich ein Data-Quality-Tool kaufen oder eine individuelle Lösung entwickeln?
Das hängt davon ab, wie viele Systeme Sie verbinden, wie spezifisch Ihre Geschäftsregeln sind und was Ihre Infrastruktur bereits unterstützt. Viele Organisationen nutzen Standardwerkzeuge für gängige Aufgaben wie Profiling und Deduplizierung und ergänzen individuelle Logik dort, wo ihre Prozesse einzigartig sind.
Recent Posts
September 28, 2026
September 25, 2026
September 25, 2026