
Was ist Daten-Pipeline-Überwachung? Ein Leitfaden für moderne Unternehmen
Erfahren Sie, was Daten-Pipeline-Überwachung ist, warum sie wichtig ist und wie Sie sie effektiv implementieren.
Daten fließen ständig durch Ihre Organisation. Kundeninformationen gelangen in Ihre Systeme. Transaktionsdatensätze sammeln sich in Datenbanken an. Betriebsmetriken streamen von verbundenen Geräten. Aber was passiert, wenn dieser Fluss stagniert oder abbricht? Ohne Sicht auf Ihre Daten-Pipelines bemerken Sie möglicherweise nicht, dass Ihre Analysen auf veralteten Informationen basieren, Ihre Berichte unvollständig sind oder Ihre Systeme stillschweigend ausgefallen sind, bis sich Probleme zu geschäftlichen Auswirkungen entwickeln.
Daten-Pipeline-Überwachung ist die Praxis, Daten während ihrer Bewegung durch Extraktions-, Transformations- und Ladungsprozesse zu verfolgen und Probleme zu erkennen, bevor sie sich auf Entscheidungsfindung oder Betrieb auswirken. Für moderne Unternehmen, die auf datengestützte Entscheidungen angewiesen sind, ist das Verständnis Ihrer Daten-Pipelines und die Überwachung ihrer Integrität zur Notwendigkeit geworden.
Dieser Leitfaden erklärt, was Daten-Pipeline-Überwachung wirklich ist, warum sie wichtig ist, wie sie funktioniert und was Sie für ihre effektive Implementierung benötigen.
Was ist Daten-Pipeline-Überwachung?
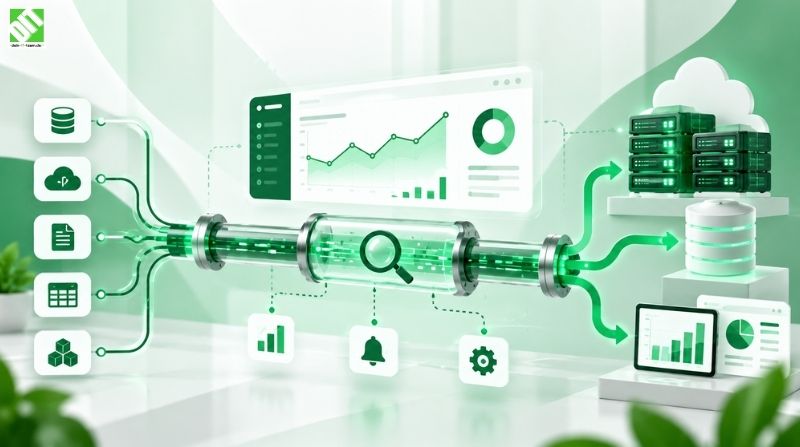
Daten-Pipeline-Überwachung ist die kontinuierliche Beobachtung von Datenablauf-Workflows, die Informationen von Quellsystemen zu Zielen bewegen. Eine Daten-Pipeline ist im Wesentlichen ein automatisierter Prozess: Daten fließen von einem Ort (einer Datenbank, Anwendung oder einem Sensor), werden transformiert oder verarbeitet und landen in einem Zielsystem oder Data Warehouse.
Stellen Sie sich das wie eine Produktionslinie vor. Produkte durchlaufen Stufen, werden bearbeitet und erreichen das Ende. Wenn eine Stufe stillschweigend zusammenbricht, produzieren Sie fehlerhafte Produkte, ohne es zu wissen. Daten-Pipelines funktionieren ähnlich. Ohne Überwachung treten beschädigte Daten, Verarbeitungsfehler oder unvollständige Übertragungen auf, ohne jemanden zu benachrichtigen.
Daten-Pipeline-Überwachung überwacht auf Probleme in jeder Phase: Senden die Quellsysteme Daten? Funktioniert die Transformationslogik korrekt? Treffen Daten pünktlich an ihrem Zielort ein? Gibt es Datenkualitätsprobleme? Die Überwachung beantwortet diese Fragen automatisch und warnt Teams, wenn etwas schiefgeht.
Die Alternative besteht darin, Probleme durch Kundenbeschwerden, inkonsistente Analysen oder Geschäftsberichte zu entdecken, die sich nicht mit der Realität decken. Bis dahin ist der Schaden angerichtet. Die Überwachung verhindert dieses Szenario, indem sie Probleme früh erkennt.
Warum Daten-Pipeline-Überwachung wichtig ist
Moderne Organisationen generieren enorme Datenmengen. Ein mittelgroßes Unternehmen könnte Dutzende von Pipelines gleichzeitig betreiben und täglich Millionen von Datensätzen bewegen. Ohne Überwachung operieren Sie im Grunde blind.
Datengestützte Entscheidungen hängen von genauen, zeitnahen Informationen ab. Wenn Ihre Analytics-Pipeline stillschweigend ausfällt, treffen Entscheidungsträger möglicherweise Maßnahmen auf der Grundlage veralteter oder unvollständiger Daten. Marketing-Teams könnten Kampagnen auf Basis falscher Metriken optimieren. Finanzteams könnten Cashflow-Muster missverstehen. Betriebliche Entscheidungen leiden, wenn die Pipeline, die Informationen an Dashboards liefert, ohne Benachrichtigung abbricht.
Pipelines fallen aus vielen Gründen aus: Quellsysteme gehen offline, Netzwerkverbindungsprobleme treten auf, Transformationen treffen auf unerwartete Datenformate, Speichersysteme gehen aus dem Speicher aus oder Verarbeitungsjobs werden zeitlich überschritten. Einige Ausfälle sind offensichtlich. Andere sind subtil. Daten könnten teilweise übertragen werden. Die Verarbeitung könnte abgeschlossen sein, aber falsche Ergebnisse liefern. Ohne Überwachung verbreiten sich diese stillen Ausfälle downstream.
Über die Genauigkeit hinaus wirken sich Pipeline-Ausfälle direkt auf Geschäftsvorgänge aus. E-Commerce-Plattformen benötigen Echtzeitbestands-Datenfluss durch Pipelines. Gesundheitssysteme benötigen funktionsfähige Patienten-Informations-Pipelines. Finanzinstitute benötigen Transaktions-Pipelines, die ohne Unterbrechung verarbeitet werden. Wenn Pipelines ausfallen oder langsamer werden, leiden Operationen sofort darunter.
Die Kosten für Pipeline-Ausfälle variieren, steigen aber grundsätzlich mit der unerkannten Zeit. Eine Stunde einer fehlgeschlagenen Analytics-Pipeline könnte ärgerlich sein. Ein Tag könnte bedeuten, dass bedeutende Geschäftsentscheidungen fälschlicherweise getroffen werden. Eine Woche bedeutet strukturelle Probleme in der Weise, wie die Organisation ihre eigenen Vorgänge versteht.
Überwachung verwandelt dies aus einer Krisenbewältigungssituation in eine verwaltete Risikosituation. Teams wissen, wann Probleme auftreten, können Fixes nach Auswirkung priorisieren und Verantwortung für Datenkualität und Verfügbarkeit übernehmen.
Schlüsselkomponenten der Daten-Pipeline-Überwachung
Eine effektive Pipeline-Überwachung erfordert die Beobachtung mehrerer Dimensionen der Pipeline-Integrität.
Datenvolumen-Überwachung verfolgt, ob erwartete Datenmengen durch die Pipeline fließen. Ungewöhnliche Volumenmuster deuten oft auf Probleme hin, bevor sie zu offensichtlichen Fehlern werden. Ein plötzlicher Rückgang der Daten, die ihr Ziel erreichen, deutet auf vorgelagerte Probleme hin. Unerwartete Volumenspitzen könnten auf Datenduplizierung oder Verarbeitungsschleifen hindeuten.
Latenzmessung gemessen, wie lange Daten brauchen, um von der Quelle zum Ziel zu gelangen. Für Echtzeit-Analytics spielen Minutenverzögerungen eine Rolle. Bei Batch-Prozessen könnten stundenlange Verzögerungen akzeptabel sein. Die Überwachung stellt Basiserwartungen auf und warnt Teams, wenn die Datenverarbeitung unerwartet verlangsamt.
Datenkualitäts-Überwachung validiert, dass Daten, die an Zielen ankommen, erwartete Standards erfüllen. Dies umfasst Formatvalidierung (ist Daten in der erwarteten Struktur?), Vollständigkeitsprüfungen (sind alle erforderlichen Felder vorhanden?), Genauigkeitsvalidierung (fallen Werte in erwartete Bereiche?), und Konsistenzprüfungen (stimmen Daten mit historischen Mustern überein?). Daten können pünktlich und vollständig im Volumen ankommen, während sie trotzdem beschädigt oder falsch sind.
Fehlerquoten-Überwachung verfolgt, ob Verarbeitungsjobs auf Fehler treffen. Einige Fehler sind wiederherstellbar. Andere unterbrechen die Verarbeitung. Die Überwachung unterscheidet zwischen akzeptablen Fehlerquoten (inhärent in der Datenverarbeitung) und problematischen Quoten, die auf systematische Probleme hindeuten.
Systemintegritäts-Überwachung prüft die Infrastruktur, die Pipelines unterstützt: CPU-Auslastung, Speicherverbrauch, Speicherkapazität, Netzwerkdurchsatz. Infrastrukturprobleme manifestieren sich oft als Pipeline-Probleme. Ein volles Speichersystem stoppt die Datenaufnahme. CPU-Engpässe verlangsamen die Verarbeitung.
Diese Dimensionen arbeiten zusammen. Eine Pipeline könnte Daten pünktlich liefern (gute Latenz), aber Datenkqualitätsprüfungen könnten offenbaren, dass die Informationen beschädigt sind. Das Volumen könnte korrekt aussehen, aber die Latenzmessung zeigt, dass die Verarbeitung dreimal länger dauert als üblich. Eine umfassende Überwachung beobachtet alle Dimensionen.
Häufige Herausforderungen bei der Daten-Pipeline-Überwachung
Organisationen, die die Pipeline-Überwachung implementieren, stoßen auf vorhersehbare Herausforderungen.
Heterogene Umgebungen erschweren die Überwachung. Moderne Daten-Stacks mischen On-Premise-Datenbanken, Cloud-Speicher, APIs und spezialisierte Data Warehouses. Verschiedene Technologien haben unterschiedliche Protokollierungsstandards, Metrik-Formate und Überwachungsschnittstellen. Eine einheitliche Überwachungslösung muss diese Vielfalt übersetzen.
Die Komplexität der Datenkqualität übersteigt einfache Volumen- und Latenztests. Echte Daten sind messy. Historische Daten könnten Qualitätsprobleme haben. Transformationen führen manchmal zu subtilen Fehlern, die keine direkten Fehler verursachen, aber downstream-Analytics beeinflussen. Um "gute Daten" gut genug zu definieren, um automatisch zu überwachen, erfordert Geschäftsbereichskompetenz kombiniert mit technischem Verständnis.
Alarm-Überflutung untergräbt die Wirksamkeit der Überwachung. Zu viele Alarme und Teams hören auf zu achten. Zu wenige und Sie verpassen Probleme. Die Optimierung von Alarm-Schwellwerten erfordert das Verständnis des Basisverhaltens, der erwarteten Variabilität und dessen, was tatsächlich wichtig ist. Ein Anstieg der Verarbeitungszeit für eine Pipeline könnte normal sein, während derselbe Anstieg für eine andere auf Probleme hindeuten könnte.
Das Debuggen von Pipeline-Fehlern ist komplex, da Probleme von mehreren Stellen stammen können: Quelldaten-Qualitätsprobleme, Transformationslogikfehler, Infrastruktur-Einschränkungen oder Zielsystem-Probleme. Die Überwachung muss genügend diagnostische Informationen liefern, um die Ursache schnell zu identifizieren.
Die Integration in bestehende Entwicklungs- und Operationsabläufe ist praktisch wichtig. Ein Überwachungssystem, das nützliche Alarme erzeugt, aber nicht mit Incident-Management-Systemen, Ticketing-Systemen oder Kommunikationstools integriert ist, wird ignoriert. Die Überwachung muss in die Art passen, wie Teams tatsächlich arbeiten.
Wie Daten-Pipeline-Überwachung technisch funktioniert
Im Kern umfasst die Daten-Pipeline-Überwachung drei Komponenten: Erfassung, Analyse und Alerting.
Die Erfassung sammelt Metriken und Protokolle aus Pipelines. Verschiedene Pipeline-Technologien stellen unterschiedliche Informationen bereit. Ein Cloud-Data-Warehouse stellt Metriken durch APIs bereit. Ein benutzerdefiniertes Python-Skript, das in Protokolle schreibt, erzeugt Textausgabe. ETL-Tools wie Apache Airflow generieren Job-Ausführungsdatensätze. Überwachungssysteme müssen aus diversen Quellen erfassen und die Daten in ein einheitliches Format normalisieren.
Die Analyse untersucht erfasste Daten, um Probleme zu identifizieren. Eine einfache Analyse überwacht Schwellwert-Verstöße: Wenn die Latenz die erwartete Obergrenze übersteigt, stimmt etwas nicht. Ausgefeiltere Analysen suchen nach Muster-Abweichungen: Wenn die Verarbeitungszeit mehr variiert als historische Normen, könnten es Kapazitätsprobleme sein. Machine-Learning-Ansätze lernen Normalbehavior-Muster und warnen bei Anomalien.
Alerting benachrichtigt relevante Teams, wenn Probleme auftreten. Effektives Alerting ist gezielt: Infrastruktur-Teams erhalten Infrastruktur-Alarme, Daten-Ingenieure erhalten Datenkqualitäts-Alarme, Analytics-Teams erhalten Latenzmeldungen. Alerting sollte umsetzbar sein: nicht nur "etwas ist fehlgeschlagen", sondern "der morgendliche ETL-Job traf auf 250 Null-Werte im Feld customer_id ab 3:47 Uhr an, was zu 15-minütiger Verarbeitungsverzögerung führte."
Es gibt verschiedene Überwachungsansätze. Application Performance Monitoring (APM)-Tools konzentrieren sich auf Metriken auf Anwendungsebene. Infrastruktur-Überwachungstools konzentrieren sich auf Server, Datenbanken und Netzwerke. Daten-Pipeline-spezifische Überwachungstools verstehen Pipeline-Konzepte wie Jobs, Transformationen und Datenkvalität. Viele Organisationen kombinieren mehrere Ansätze.
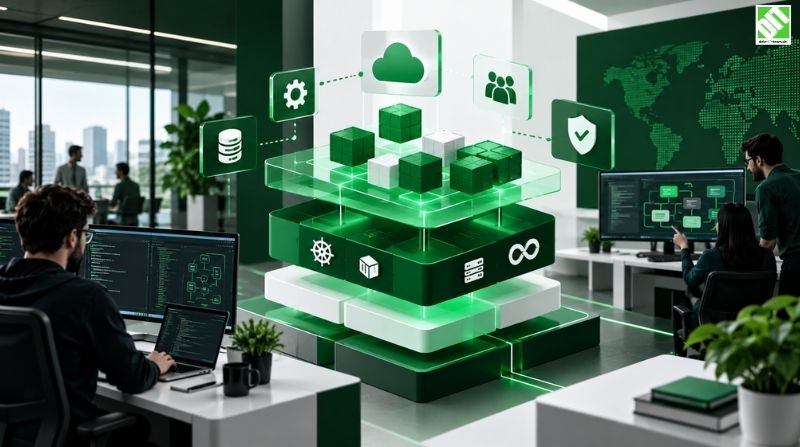
DevOps-Praktiken beinhalten zunehmend die Pipeline-Überwachung als grundlegende Infrastruktur. Das Behandeln von Daten-Pipelines mit der gleichen Strenge wie Anwendungs-Deployment-Pipelines bedeutet Überwachungs-, Alarming-, Versionierungs- und Test-Infrastruktur, die reife Operations-Teams bereits kennen.
Aufbau einer Daten-Pipeline-Überwachungsstrategie
Eine effektive Überwachung beginnt mit Klarheit darüber, was für Ihr Geschäft am wichtigsten ist.
Identifizieren Sie zunächst kritische Pipelines. Nicht alle Pipelines sind gleich wichtig. Die Pipeline, die Ihr Echtzeit-Analytics-Dashboard speist, ist wichtiger als die Pipeline, die historische Protokolle archiviert. Die Pipeline, die Zahlungstransaktionen verarbeitet, ist wichtiger als die, die unkritische Referenzdaten aktualisiert. Priorisieren Sie Überwachungsressourcen auf Pipelines mit höchster Geschäftsauswirkung.
Definieren Sie SLAs (Service Level Agreements) für kritische Pipelines. Wie schnell sollten Daten an Zielen ankommen? Welche Datenkualitätsstandards müssen eingehalten werden? Welche Betriebszeit ist akzeptabel? Diese SLAs werden zur Grundlage für Überwachungsschwellwerte. Eine Pipeline mit garantiertem 99,9% Betrieb sollte anders warnen als eine mit 95% Betriebszeiterwartungen.
Etablieren Sie Baseline-Verhalten. Bevor Sie bei Anomalien alarmieren, verstehen Sie, wie Normalität aussieht. Dies könnte bedeuten, Pipelines wochenlang ohne Alarme auszuführen, um typische Latenz, Fehlerquoten und Volumenmuster zu etablieren. Baseline-Daten verhindern Fehlalarme von natürlicher Variabilität.
Wählen Sie angemessene Tools und Technologien aus. Einige Organisationen erstellen benutzerdefinierte Überwachung auf Basis bestehender Infrastruktur-Überwachungstools. Andere nutzen Pipeline-spezifische Überwachungsplattformen. Die richtige Wahl hängt von bestehenden Technologie-Investitionen, Pipeline-Komplexität, Team-Kompetenz und Budget ab.
Integrieren Sie die Überwachung in Incident-Response-Workflows. Überwachung ist nutzlos, wenn Alarme nirgendwo hingehen. Definieren Sie, wer für verschiedene Alarm-Typen benachrichtigt wird, wie schnell sie reagieren sollten, welche diagnostischen Schritte sie unternehmen sollten und wie sie eskalieren, falls erforderlich.
Technologische Überlegungen für die Daten-Pipeline-Überwachung
Die Implementierung der Pipeline-Überwachung erfordert das Verständnis verfügbarer Technologien und Ansätze.
Cloud-native Lösungen nutzen in Cloud-Plattformen integrierte Überwachungen. AWS CloudWatch, Azure Monitor und Google Cloud Logging bieten Pipeline-Sichtbarkeit für Workloads, die auf diesen Plattformen ausgeführt werden. Dies sind oft der einfachste Ausgangspunkt, wenn Ihre Infrastruktur Cloud-basiert ist.
Open-Source-Tools wie Prometheus und Grafana bieten flexible Überwachungsinfrastruktur. Diese erfordern mehr Konfiguration, bieten aber maximale Anpassung. Organisationen mit anspruchsvollen Überwachungsanforderungen kombinieren diese häufig mit Pipeline-spezifischen Lösungen.
Benutzerdefinierte Softwarelösungen speziell für Ihre Pipeline-Architektur könnten für komplexe Umgebungen sinnvoll sein. Diese Lösungen integrieren sich direkt mit Ihren Daten-Stacks, verstehen Ihren Geschäftskontext und erzeugen Überwachungen, die speziell für Ihre Vorgänge relevant sind.
Data-Warehouse-native Überwachung nutzt Analytics-Fähigkeiten in Ihrem Data Warehouse, um sich selbst und verbundene Systeme zu überwachen. Ein Data Warehouse kann Abfragen ausführen, die Datenkualitätsprobleme erkennen, in sich gespeicherte Pipeline-Performance-Protokolle analysieren und Alarme generieren.
API-basierte Überwachung verbindet sich über ihre APIs mit Pipeline-Systemen, sammelt Metriken und Protokolle ohne direkten Infrastruktur-Zugriff zu benötigen. Dies funktioniert gut, wenn Pipelines auf verwalteten Diensten oder SaaS-Plattformen ausgeführt werden.
Der richtige Ansatz kombiniert oft mehrere Technologien, anstatt sich auf ein einzelnes Tool zu verlassen.
Datenkqualitäts-Überwachung im Detail
Die Datenkqualitäts-Überwachung verdient besondere Aufmerksamkeit, da sie gleichzeitig am komplexesten und wertvollsten ist.
Schemavalidierung stellt sicher, dass Daten erwartete Strukturen erfüllen. Wenn ein Feld, das Zahlen enthalten sollte, Text enthält, erkennt die Schemavalidierung dies. Wenn erforderliche Felder fehlen, erkennt die Validierung dies. Dies ist grundlegend: Sie können Daten nicht zuverlässig verarbeiten, wenn sie nicht der erwarteten Struktur entsprechen.
Referenzielle Integritätsprüfungen verifizieren, dass Beziehungen zwischen Daten erhalten bleiben. Wenn eine Kundentransaktion auf eine Kunden-ID verweist, die nicht in der Kundentabelle existiert, kennzeichnen Referenzielle Integritätsprüfungen dies. Diese Prüfungen erkennen logische Inkonsistenzen in Daten.
Bereichs- und Formatvalidierung stellt sicher, dass Werte sinnvoll sind. Temperaturen außerhalb physikalisch möglicher Bereiche, Daten in unmöglichen Formaten, Geldbeträge mit ungültige Währungscodes—Validierung erkennt unmögliche Werte.
Eindeutigkeits- und Deduplizierungsprüfungen verhindern doppelte Daten. Einige Pipelines sollten eindeutige Datensätze erzeugen. Duplikate deuten auf Verarbeitungsfehler oder Datenbeschädigung hin.
Statistische Profilerstellung überwacht Datenmerkmale. Wenn E-Mail-Adressen normalerweise Kleinbuchstaben sind, aber plötzlich 20% gemischter Fall sind, erkennt die Profilerstellung ungewöhnliche Muster. Wenn numerische Felder konsistente Werte durchschnittlich aufweisen, aber plötzlich sich der Durchschnitt verdoppelt, hat sich etwas geändert.
Vollständigkeits-Überwachung verfolgt, ob Pipelines erwartete Daten liefern. Treffen erwartete Datensätze ein? Stimmen die Anzahlen mit Erwartungen überein? Sind irgendwelche Felder systematisch null?
Diese Qualitätsprüfungen erfordern das Verständnis, was "gute Daten" für Ihr Geschäft bedeutet. Dieses Verständnis kommt oft von Daten-Ingenieuren, die mit den Daten gearbeitet haben, Geschäftsanalytikern, die Datensemantik verstehen, und Erfahrung beim Erkennen vergangener Datenprobleme.
Häufige Anwendungsfälle für Daten-Pipeline-Überwachung
Verschiedene Organisationen verwenden Pipeline-Überwachung unterschiedlich basierend auf ihrer Datenmaturität und Geschäftsanforderungen.
Analytics-Pipeline-Überwachung stellt sicher, dass Business-Intelligence-Systeme genaue, zeitnahe Daten erhalten. Marketing-Teams benötigen Verkehrsdaten, die zuverlässig in Analytics-Plattformen fließen. Finance-Teams benötigen täglich verarbeitete Transaktionsdaten. Wenn Analytics-Pipelines ausfallen, leidet die Entscheidungsfindung sofort.
Echtzeit-Operationspipelines erfordern andere Überwachung als Batch-Analytics. Eine Echtzeit-Bestands-Pipeline für E-Commerce benötigt Sichtbarkeit auf Sekundenbasis. Kleine Verzögerungen kaskadieren in nach vorne gerichtete Kundenprobleme. Latenzmessung wird kritisch.
Data-Warehouse-Überwachung stellt sicher, dass das zentrale Daten-Repository zuverlässig Daten erhält und die Qualität aufrechterhält. Das Data Warehouse ist oft die Quelle der Wahrheit für Analytics, sodass seine Zuverlässigkeit direkt das Organisationsvertrauen in Daten beeinflusst.
Machine-Learning-Pipeline-Überwachung stellt sicher, dass Trainingsdaten zuverlässig an Modell-Entwicklungssysteme fließen und Modell-Vorhersagen zuverlässig an Anwendungen fließen. ML-Pipelines sind besonders empfindlich gegenüber Datenkualitätsproblemen, da schlechte Trainingsdaten stillschweigend schlechte Modelle produzieren.
Compliance- und Audit-Pipelines benötigen Überwachung, um sicherzustellen, dass für regulatorische Berichte erforderliche Daten korrekt fließen und gemäß Regeln transformiert werden.
Implementierung der Pipeline-Überwachung: Praktische Schritte
Organisationen implementieren die Überwachung typischerweise schrittweise, anstatt sofort umfassende Überwachung zu versuchen.
Beginnen Sie klein mit kritischen Pipelines. Wählen Sie eine oder zwei Pipelines mit höchster Geschäftsauswirkung aus und implementieren Sie die Überwachung dort zunächst. Dies ermöglicht das Lernen, was Überwachung tatsächlich erfordert, bevor Sie erweitern.
Verwenden Sie bestehende Überwachungsinfrastruktur, wo möglich. Wenn Sie bereits Infrastruktur-Überwachungstools haben, beginnen Sie dort. Fügen Sie spezialisierte Überwachung schrittweise hinzu.
Definieren Sie Baseline-Erwartungen, bevor Sie Alarme aktivieren. Führen Sie die Überwachung mehrere Wochen stillschweigend aus und sammeln Sie Baseline-Daten über normales Verhalten, bevor Sie Alarme aktivieren.
Beginnen Sie mit einfacher Überwachung und fügen Sie dann Ausgefeiltheiten hinzu. Einfache Latenz- und Volumen-Überwachung könnte 80% der Probleme erkennen. Fügen Sie Datenkwalitätsprüfungen hinzu, nachdem sich die Basisüberwachung stabilisiert.
Integrieren Sie die Überwachung in Incident-Response. Stellen Sie sicher, dass die Überwachung tatsächlich ändert, wie Teams auf Probleme reagieren. Wenn die Überwachung existiert, aber nicht mit Incident-Workflows verbunden ist, profitieren Teams nicht davon.
Investieren Sie in Team-Wissen. Überwachungssysteme laufen nicht von selbst. Jemand muss verstehen, was verschiedene Metriken bedeuten, wie man Alarme einstellt und wie man Überwachungsdaten nutzt, um Pipelines zu verbessern.
Fazit
Daten-Pipeline-Überwachung transformiert die Art, wie Organisationen Daten-Infrastruktur verwalten. Ohne Überwachung bleiben Pipeline-Ausfälle unsichtbar, bis sie Geschäftsentscheidungen oder Vorgänge schädigen. Mit Überwachung werden Probleme schnell erkannt, was eine schnelle Reaktion ermöglicht.
Die Implementierung einer effektiven Überwachung erfordert das Verständnis dessen, was Sie überwachen, warum verschiedene Metriken wichtig sind und wie Sie Überwachungsdaten in Maßnahmen umwandeln. Es geht nicht nur um Technologieauswahl, sondern auch um Organisationspraxis: Definieren von SLAs, Etablieren von Baselines und Integration der Überwachung in Incident-Response-Workflows.
Die gute Nachricht ist, dass Überwachung keine Perfektion erfordert. Das Starten mit einfacher Überwachung kritischer Pipelines erkennt oft die meisten Probleme. Wenn die Überwachung reift, fügen Organisationen Ausgefeiltheiten hinzu—Qualitätsprüfungen, ML-basierte Anomalieerkennung und tiefere diagnostische Fähigkeiten.
Wenn Ihre Organisation Daten-Infrastruktur aufbaut oder erweitert, ist die Behandlung der Pipeline-Überwachung als grundlegende Komponente anstelle eines Nachgedankens hilfreich. Der Aufbau oder die Verbesserung der Daten-Pipeline-Überwachung beinhaltet oft das Verständnis bestehender Technologie-Stacks, die Integration der Überwachung über diverse Plattformen und möglicherweise den Aufbau benutzerdefinierter Lösungen, die an spezifische Geschäftsanforderungen ausgerichtet sind. Dies sind genau die Herausforderungen, die technische Teams handhaben, und sie sind auch die Herausforderungen, wo Kompetenz in Cloud-Integration und Daten-Infrastruktur Dividenden zahlt. Wenn Sie evaluieren, wie Sie die Pipeline-Überwachung in Ihrer Organisation angehen möchten, oder Anleitung beim Aufbau von Überwachung für komplexe Daten-Umgebungen benötigen, hilft das Diskutieren Ihrer spezifischen Situation dabei zu klären, welcher Überwachungsansatz für Ihr Geschäft sinnvoll ist.
Sprechen Sie mit unserem Business Manager oder fordern Sie jetzt ein kostenloses Angebot an!
Häufig gestellte Fragen
Was ist der Unterschied zwischen Daten-Pipeline-Überwachung und Infrastruktur-Überwachung?
Infrastruktur-Überwachung überwacht Server, Datenbanken und Netzwerke. Daten-Pipeline-Überwachung überwacht Daten selbst: ob sie fließen, pünktlich ankommen und die Qualität erhalten. Sie benötigen beides. Infrastruktur-Probleme verursachen Pipeline-Fehler, aber dass die Infrastruktur gesund aussieht, garantiert nicht Datenkqualität oder pünktliche Lieferung.
Wie überwachen Sie die Datenkqualität automatisch?
Datenkqualitäts-Überwachung nutzt Regeln, die Daten gegen Erwartungen prüfen: Entspricht sie dem erwarteten Format, enthält sie erforderliche Felder, fallen Werte in gültige Bereiche, stimmt sie mit historischen Mustern überein? Diese Regeln werden automatisch auf eingehende Daten angewendet und warnen bei Verstößen.
Was ist eine akzeptable Latenz für Daten-Pipelines?
Das hängt völlig von Ihrem Anwendungsfall ab. Echtzeit-Operationssysteme könnten Latenz auf Minuten- oder Sekundenebene erfordern. Analytics-Systeme könnten Stunden-Latenz akzeptieren. Batch-Verarbeitung könnte einmal täglich ausgeführt werden. Definieren Sie SLAs basierend auf der Art, wie Sie die Daten tatsächlich nutzen.
Können Sie Pipelines, die mit verschiedenen Technologien erstellt sind, zusammen überwachen?
Ja, aber es erfordert einen Überwachungsansatz, der über Ihren Technology Stack funktioniert. Cloud-Überwachungstools funktionieren gut für Cloud-basierte Pipelines. Open-Source-Tools wie Prometheus bieten Flexibilität über diverse Technologien. Manchmal bedeutet dies, mehrere Überwachungslösungen zu kombinieren.
Was sollten Sie tun, wenn die Pipeline-Überwachung ein Problem erkennt?
Haben Sie einen Prozess im Voraus definiert: wer benachrichtigt wird, wie schnell sie reagieren sollten, welche diagnostischen Schritte sie unternehmen sollten und wie sie eskalieren, falls erforderlich. Die Überwachung ist nur wertvoll, wenn sie mit Reaktionsprozessen verbunden ist.
Wie stimmen Sie Alarm-Schwellwerte für Pipeline-Überwachung ab, um Falschalarme zu vermeiden?
Erstellen Sie eine Baseline des normalen Verhaltens, bevor Sie Produktionsalarme aktivieren. Verstehen Sie natürliche Variabilität in Ihren Pipelines. Setzen Sie Alarm-Schwellwerte basierend auf dem, was tatsächlich auf Probleme hinweist, anstelle von geringen Abweichungen von Durchschnitten. Iterieren Sie über Schwellwerte basierend auf Fehlalarm-Mustern.
Sollten Sie die Überwachung intern erstellen oder bestehende Tools verwenden?
Beide haben Gültigkeit. Off-the-Shelf-Tools erfordern weniger Entwicklung, könnten aber nicht perfekt zu Ihrer Umgebung passen. Benutzerdefinierte Überwachung versteht Ihre spezifischen Pipelines, erfordert aber mehr Wartung. Viele Organisationen beginnen mit bestehenden Tools und erstellen dann benutzerdefinierte Lösungen für spezifische Anforderungen.
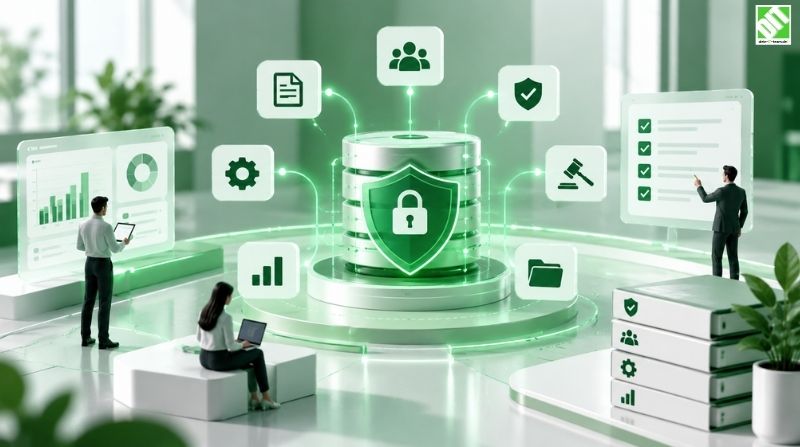
Wie hängt die Pipeline-Überwachung mit Data Governance zusammen?
Die Pipeline-Überwachung stellt sicher, dass Daten die von Governance-Richtlinien definierten Qualitätsstandards erfüllen. Governance definiert "was Qualität bedeutet", Überwachung stellt sicher, dass Daten tatsächlich diese Standards erfüllen. Sie sind komplementär: Governance ohne Überwachung ist aspirativ; Überwachung ohne Governance fehlt die Richtung.
Was sind die Kosten für die Implementierung der Pipeline-Überwachung?
Das hängt von Ihrer Daten-Komplexität und Werkzeugwahl ab. Cloud-native Überwachung könnte Hunderte monatlich kosten. Enterprise-Überwachungsplattformen könnten Tausende monatlich kosten. Benutzerdefinierte Lösungen beinhalten Engineering-Zeit. Die echte Frage ist der Kostenvergleich zu den Kosten unerkannter Pipeline-Ausfälle.
Wie bezieht sich CI/CD auf die Daten-Pipeline-Überwachung?
Kontinuierliche Integration und Bereitstellung für Daten-Pipelines bedeutet Behandlung von Pipeline-Code wie Anwendungscode: Versionskontrolle, Test und Bereitstellung durch automatisierte Prozesse. Die Pipeline-Überwachung wird Teil des CI/CD-Prozesses und stellt sicher, dass bereitgestellte Pipelines in der Produktion korrekt funktionieren.
Recent Posts
September 16, 2026
September 15, 2026
September 28, 2026